// SPIS TREŚCI
- Czym jest łańcuch myśli w prompcie
- AI jako partner w pracy, nie automat
- Kilka ścieżek myślenia zamiast jednej
- Mapa decyzyjna: z „AI wybrało” na „widzę dlaczego”
- Symulacja na Claude Opus 5.5: dwie rundy
- Co zmieniło się między rundami
- Uwaga: ocena modelu to nie wynik
- Szablon prompta do skopiowania
- Checklista
- Plan testu
- FAQ
// SERIA O PROMPTACH — 5 WPISÓW
- #054 Przykłady w prompcie
- #055 Dobre i złe przykłady + feedback
- #056 Łańcuch myśli i mapa decyzyjna ← jesteś tutaj
- #057 Inżynieria wsteczna i kampanie UGC
- #058 Struktura dobrego prompta
Czym jest łańcuch myśli w prompcie
Łańcuch myśli (chain of thought, CoT) to sposób promptowania, w którym prosisz model AI, żeby rozpisał kolejne kroki rozumowania, zanim poda odpowiedź. Zamiast „napisz 5 nagłówków” piszesz „napisz 5 nagłówków, oceń każdy, wybierz najlepszy i uzasadnij”. Model nie skacze od razu do wyniku, tylko przechodzi drogę: propozycje → ocena → wybór.
Część nowych modeli, w tym Claude Opus 5.5 w trybie rozszerzonego myślenia, rozumuje wewnętrznie, zanim odpowie. Zależy to od modelu i ustawień. Po co więc o to prosić? Bo myślenie modelu w środku jest dla niego. Rozpisany łańcuch jest dla Ciebie. Widzisz kryteria, możesz się z nimi nie zgodzić i poprawić jedno ogniwo zamiast całej odpowiedzi.
Prompt z tutoriala jest dobrym początkiem:
Napisz 5 nagłówków reklamowych dla [sklep].
Wypisz każdą propozycję.
Oceń jej mocne i słabe strony.
Wybierz jedną jako najlepszą i uzasadnij, dlaczego właśnie ta.
AI jako partner w pracy, nie automat
Pierwsza zmiana jest w głowie, nie w prompcie. Automatowi wrzucasz monetę i bierzesz, co wypadnie. Z partnerem w pracy rozmawiasz: mówisz, dla kogo piszecie, czego się boicie, jakie macie fakty. Partner ma prawo powiedzieć „nie wiem” i dopytać.
W prompcie to wygląda tak:
- jedno zdanie o roli: „jesteś moim partnerem w pracy nad reklamą, nie maszynką do nagłówków”,
- grupa docelowa i jej problem, a nie tylko branża,
- lista faktów, których wolno użyć (lekcja z #055),
- wprost: „napisz, czego nie wiesz i jakie dane zmieniłyby decyzję”.
To ostatnie zdanie robi najwięcej. Model, który dostał pozwolenie na „nie wiem”, rzadziej dopowiada brakujące liczby.
Kilka ścieżek myślenia zamiast jednej
Prompt z tutoriala ma jedną słabość: wszystkie 5 nagłówków powstaje z jednej ścieżki. Model wybiera najbardziej prawdopodobny kąt i robi 5 jego wariantów. Potem ocenia je i wybiera najlepszy z bardzo podobnych.
Dlatego zachęcam model do kilku ścieżek myślenia. Nazywam je z góry, bo wtedy każda ścieżka to inny sposób patrzenia na tego samego klienta:
W badaniach nad modelami językowymi ten pomysł ma swoje nazwy: łańcuch myśli, samospójność (kilka rozumowań i porównanie wyników) i drzewo myśli (rozgałęzianie i ocena ścieżek). Linki są w źródłach. W reklamie nie potrzebujesz teorii. Wystarczy: trzy nazwane ścieżki, po dwa nagłówki w każdej.
Mapa decyzyjna: z „AI wybrało” na „widzę dlaczego”
Mocne i słabe strony z tutoriala mają jeden problem: każdy nagłówek jest oceniany czym innym. Raz długość, raz brak dowodu, raz brak składnika. Nie da się tego porównać.
Mapa decyzyjna to zwykła tabela: wszystkie opcje × te same kryteria × oceny. Kryteria wybierasz Ty, nie model. Dla nagłówków reklamowych używam czterech:
- Konkret — czy klient wie, co dostaje.
- Oparcie w faktach — czy wszystko da się udowodnić z listy faktów.
- Zrozumiałe w 2 sekundy — tyle masz w feedzie.
- Odpowiada na problem grupy — czy trafia w to, czego klient się boi albo chce.
Z mapą zmienia się Twoja rola. Nie pytasz „który jest najlepszy?”. Patrzysz, gdzie model dał 5, a gdzie 2, i sprawdzasz, czy się zgadzasz. Jeśli nie, poprawiasz ocenę albo kryterium, a decyzja zmienia się sama.
Symulacja na Claude Opus 5.5: dwie rundy
Tym razem nowa branża: sklep internetowy z roślinami doniczkowymi. To dobry poligon do łańcucha myśli, bo klient ma tu jeden wyraźny lęk („uschnie mi”), a sklep kilka różnych odpowiedzi na niego: wysyłka, opakowanie, gwarancja, dobór rośliny. Jest z czego budować ścieżki. Marka jest wymyślona.
Runda 1: prompt z tutoriala — oceń i wybierz

To już dużo lepiej niż samo „napisz 5 nagłówków”. Model sam zauważa słabe strony, a nawet uczciwie pisze, że „48 godzin” i „ponad 100 gatunków” to jego założenia. Ale:
- wszystkie nagłówki powstały z jednej ścieżki, więc wybór jest między podobnymi,
- każdy oceniany jest czym innym, więc trudno je porównać,
- zwycięzca (#4) stoi na obietnicy, której model nie zna, i sam to przyznaje.
W tutorialu widać to samo w innej formie: ChatGPT jako „słabą stronę” wskazuje „brak dowodu społecznego (np. % kobiet, które to potwierdziły)”. To prosta droga do kolejnej rundy ze zmyślonymi procentami. O tym był wpis #055.
Runda 2: partner + trzy ścieżki + mapa decyzyjna
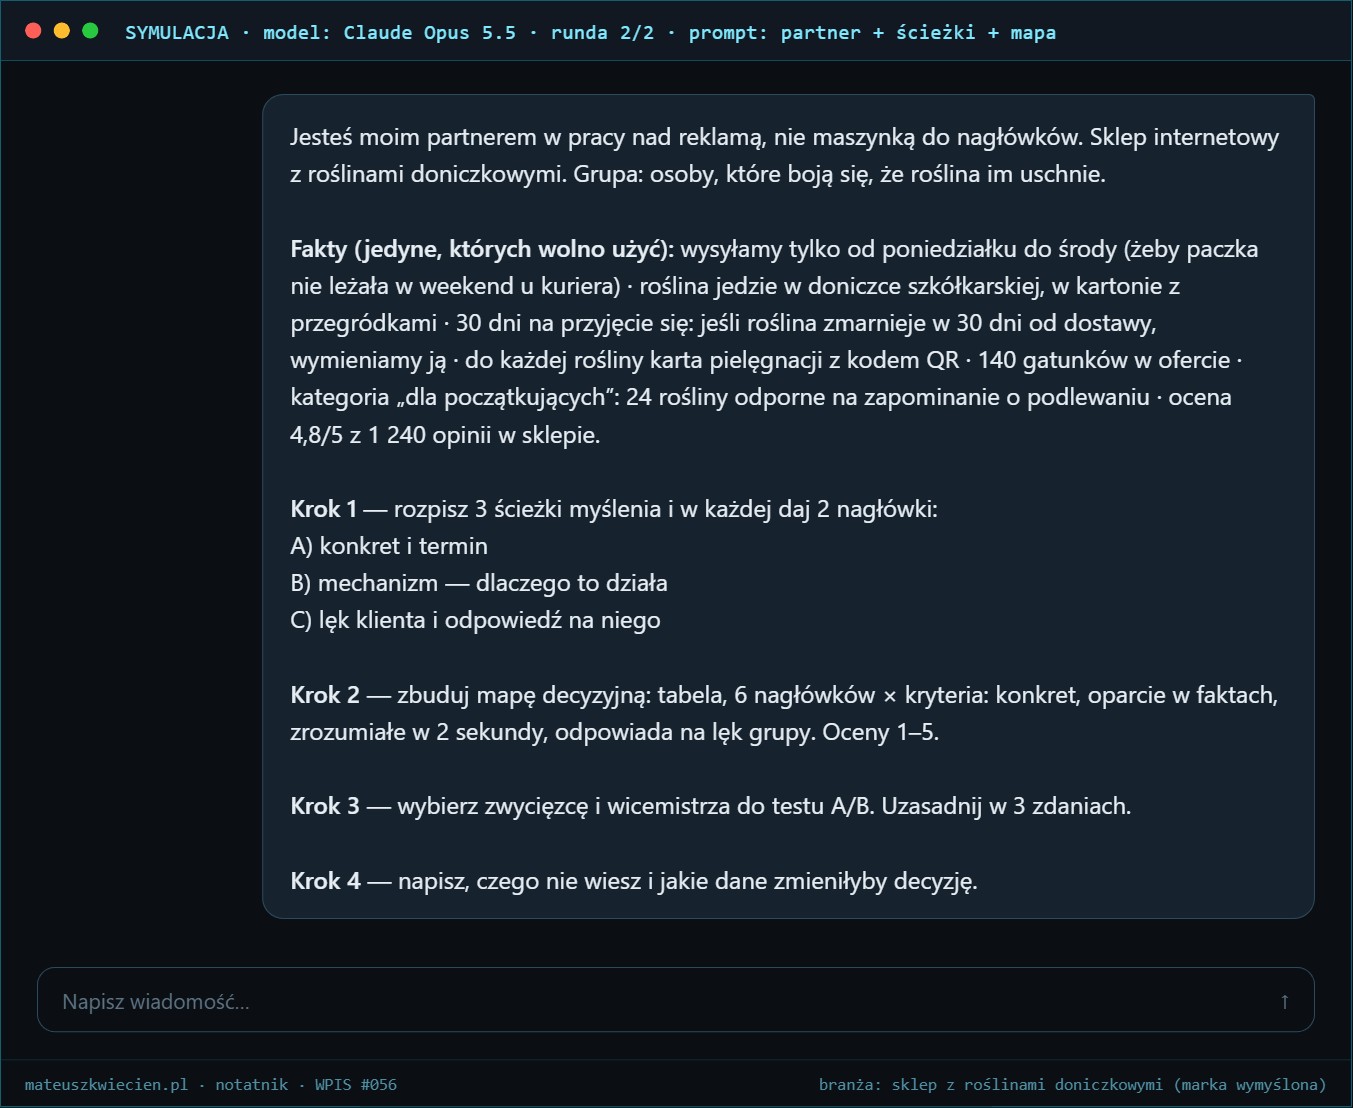


Trzy rzeczy, które tu widać:
- Różne kąty, nie warianty. „Wysyłamy od poniedziałku do środy” i „Boisz się, że uschnie?” to dwa zupełnie inne nagłówki na ten sam lęk.
- Remis jako informacja. A2 i C1 mają po 19 punktów. Model nie udaje, że jeden jest lepszy. Mówi: to dwa różne kąty, przetestuj oba.
- Partner dopytuje. Krok 4 to pytania, które zadałby dobry współpracownik: zimny ruch czy remarketing, ile wymian w ramach gwarancji, czy są zdjęcia do kreacji. Od odpowiedzi zależy, który nagłówek idzie pierwszy.
Co zmieniło się między rundami
| Runda 1: oceń i wybierz | Runda 2: partner + ścieżki + mapa | |
|---|---|---|
| Rola AI | wykonawca | partner, który może powiedzieć „nie wiem” |
| Skąd nagłówki | jedna ścieżka, 5 wariantów | 3 nazwane ścieżki po 2 nagłówki |
| Ocena | mocne i słabe strony, każda innym miarą | te same 4 kryteria dla wszystkich, skala 1–5 |
| Fakty | brak, model zgaduje | lista faktów, nic spoza niej |
| Wynik | „najlepszy” nagłówek | zwycięzca + wicemistrz do testu A/B + lista braków |
| Kto decyduje | model | Ty, z mapą przed oczami |
Uwaga: ocena modelu to nie wynik
Mapa decyzyjna wygląda jak dane, ale nimi nie jest. „19 punktów” to opinia modelu na podstawie Twoich kryteriów, a nie klikalność. Dlatego w prompcie każę mu na końcu to napisać, a w notatniku trzymam się prostej zasady: mapa decyduje, co przetestować, a test A/B decyduje, co działa. Wyników z takiego testu tu nie pokazuję, bo to symulacja.
Cztery rzeczy, które trzeba wiedzieć o mapie decyzyjnej
- Kryterium, które wszyscy spełniają, nie jest kryterium. W symulacji kolumna „Fakty” ma same piątki, bo prompt i tak zabraniał wychodzić poza listę faktów. To warunek wejścia, a nie coś, co różnicuje nagłówki. Takie kryterium lepiej wyjąć z tabeli i sprawdzić osobno: „czy wszystko jest z faktów? tak / nie”.
- Kryteria mają różną wagę. W prostej sumie „zrozumiałe w 2 sekundy” waży tyle samo co „odpowiada na lęk grupy”. Jeśli dla Ciebie lęk jest dwa razy ważniejszy, napisz to w prompcie: „lęk grupy liczy się ×2”. Wtedy remis A2 i C1 może zniknąć.
- Model ocenia własne teksty łagodnie. Ten sam model, który napisał nagłówki, zwykle wystawia im dobre oceny. Lepiej: kryteria piszesz Ty, a ocenę robisz w osobnej rozmowie, w której wklejasz same nagłówki bez informacji, kto je napisał.
- Łańcuch myśli kosztuje. Dłuższa odpowiedź to więcej czasu i więcej tokenów (przy pracy przez API — więcej pieniędzy). Przy prostym zadaniu, np. poprawieniu literówek, nie ma sensu. Opłaca się tam, gdzie wybierasz między opcjami i chcesz rozumieć dlaczego.
Szablon prompta do skopiowania
Jesteś moim partnerem w pracy nad [reklamą / wpisem / mailem], nie maszynką do [nagłówków].
[Firma / sklep]. Grupa: [kto] — [czego się boi albo czego chce].

FAKTY (jedyne, których wolno użyć):
- [fakt 1]
- [fakt 2]
- [fakt 3]

KROK 1 — rozpisz 3 ścieżki myślenia i w każdej daj 2 propozycje:
A) [konkret i termin]
B) [mechanizm — dlaczego to działa]
C) [problem klienta i odpowiedź na niego]

KROK 2 — zbuduj mapę decyzyjną: tabela, wszystkie propozycje × kryteria:
[konkret], [oparcie w faktach], [zrozumiałe w 2 sekundy], [odpowiada na problem grupy]. Oceny 1–5.

KROK 3 — wybierz zwycięzcę i wicemistrza do testu A/B. Uzasadnij w 3 zdaniach.

KROK 4 — napisz, czego nie wiesz i jakie dane zmieniłyby decyzję.
Zaznacz, że oceny w tabeli to Twoja ocena, nie wynik testu.
Checklista
- AI dostało rolę partnera i prawo do „nie wiem”.
- Jest grupa docelowa i jej problem, nie tylko branża.
- Jest lista faktów i zakaz wychodzenia poza nią.
- Ścieżki myślenia są nazwane z góry i naprawdę różne.
- Kryteria mapy wybrałeś Ty i są takie same dla wszystkich opcji.
- Wynik to zwycięzca + wicemistrz do testu, nie jedna „najlepsza” odpowiedź.
- Model napisał, czego nie wie. Odpowiedziałeś mu i poprosiłeś o przeliczenie mapy.
Plan testu: jak to sprawdzić na prawdziwej reklamie
Tej techniki nie testowałem jeszcze na płatnej kampanii, więc zamiast wyników daję plan, który każdy może powtórzyć na swoim koncie.
- Dwa prompty: A — „oceń mocne i słabe strony, wybierz najlepszy”; B — partner + 3 ścieżki + mapa decyzyjna z Twoimi kryteriami i wagami.
- Z każdego weź 2 najlepsze teksty według siebie, nie według modelu.
- Puść je jako warianty w jednej kampanii (Meta Ads: ten sam zestaw reklam, ta sama grupa odbiorców, ten sam budżet).
- Mierz: CTR i koszt kliknięcia; w wariancie B dodatkowo sprawdź, czy zwycięzca z mapy wygrał też w teście — to powie Ci, czy Twoje kryteria są dobre.
- Czekaj minimum 7 dni albo do ok. 1000 wyświetleń na wariant, zanim cokolwiek wyłączysz.
- Jeśli mapa regularnie typuje przegranych, zmień kryteria albo wagi, a nie model.
Gdy ten test zrobię na sklepie, dopiszę wyniki tutaj z datą aktualizacji.
FAQ
Co to jest łańcuch myśli (chain of thought) w prompcie?
To sposób promptowania, w którym prosisz model AI o rozpisanie kolejnych kroków rozumowania przed odpowiedzią, np. propozycje, ocena każdej i wybór z uzasadnieniem. Dzięki temu widzisz, jak model doszedł do wyniku, i możesz poprawić jedno ogniwo zamiast całej odpowiedzi.
Czy nowe modele AI nie myślą same, bez proszenia?
Wiele nowych modeli rozumuje wewnętrznie przed odpowiedzią. Rozpisany łańcuch myśli jest jednak dla Ciebie: pokazuje kryteria i oceny, z którymi możesz się nie zgodzić. To narzędzie kontroli, a nie tylko sposób na lepszy wynik.
Co to jest mapa decyzyjna w pracy z AI?
To tabela, w której wszystkie opcje przygotowane przez model są oceniane na tych samych kryteriach, np. konkret, oparcie w faktach, zrozumiałość w 2 sekundy i dopasowanie do problemu klienta. Mapa pokazuje, dlaczego model coś wybrał, a decyzję podejmujesz Ty.
Po co prosić AI o kilka ścieżek myślenia?
Bo jedna ścieżka daje kilka wariantów tego samego pomysłu. Nazwane ścieżki, np. konkret, mechanizm i lęk klienta, dają naprawdę różne kąty, które warto porównać i przetestować.
Czy oceny z mapy decyzyjnej można traktować jak wyniki?
Nie. To opinia modelu na podstawie Twoich kryteriów. Wyniki daje dopiero test A/B na prawdziwej reklamie. Mapa służy do wyboru, co przetestować.
Źródła
- Anthropic, Let Claude think (chain of thought prompting) — dokumentacja
- Wei i in., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, 2022
- Wang i in., Self-Consistency Improves Chain of Thought Reasoning in Language Models, 2022
- Yao i in., Tree of Thoughts: Deliberate Problem Solving with Large Language Models, 2023
- Symulacja rozmowy: Claude Opus 5.5, 8 października 2026, marka sklepu wymyślona na potrzeby wpisu
Powiązane w notatniku: ciąg dalszy: inżynieria wsteczna i kampanie UGC (WPIS #057), przykłady w prompcie (WPIS #054), dobre i złe przykłady w prompcie (WPIS #055), jak testować prompt czatu.