// SPIS TREŚCI
// SERIA O PROMPTACH — 5 WPISÓW
- #054 Przykłady w prompcie
- #055 Dobre i złe przykłady + feedback ← jesteś tutaj
- #056 Łańcuch myśli i mapa decyzyjna
- #057 Inżynieria wsteczna i kampanie UGC
- #058 Struktura dobrego prompta
Przykład z komentarzem, czyli jak AI łączy kropki
We wpisie #054 powtarzałem: przykłady, przykłady, przykłady. Dziś dokładam drugą połowę tej lekcji. Sam przykład mówi modelowi co Ci się podoba. Nie mówi dlaczego. A bez „dlaczego” model zgaduje, co w tym przykładzie jest ważne: długość? cudzysłów? liczba? temat? Często zgaduje źle.
Dlatego przy każdym przykładzie dopisuję strzałkę i jedno zdanie komentarza:
„Palona we wtorek, u Ciebie w czwartek”
→ konkretny termin, świeżość, którą da się sprawdzić.
Przykład to kropka. Komentarz to linia, która mówi, jak tę kropkę połączyć z następną. Trzy przykłady z komentarzem i model sam wyciąga regułę: „ten człowiek chce terminu, sprawdzalnej korzyści i zwrotu do klienta”. To jest właśnie łączenie kropek. Ty nie piszesz regulaminu na dwie strony, tylko pokazujesz wzór i mówisz, na co patrzeć.
Złe przykłady działają tak samo mocno jak dobre
Druga rzecz, która mnie przekonała: AI bardzo dobrze reaguje na anty-przykłady. Dobry przykład pokazuje kierunek. Zły przykład stawia płot. Model widzi nie tylko „idź tam”, ale też „tu nie wchodź”.
- Frazes — „Kawa palona z pasją” → tak pisze każda palarnia, zero informacji.
- Obietnica bez dowodu — „Najlepsza kawa w Polsce” → nie do sprawdzenia.
- Zmyślona liczba — „9 na 10 klientów poleca” → nie ma takiego badania.
Trzy zasady, żeby zły przykład pomagał, a nie szkodził:
- Zawsze podpisz go jako ZŁY i oddziel od dobrych. Bez etykiety model może go potraktować jak wzór.
- Zawsze dopisz „→ dlaczego”. Sam zły przykład bez komentarza to tylko kolejny tekst w prompcie.
- Celuj w błędy, które model naprawdę robi. Najlepsze anty-przykłady biorę z jego wcześniejszych odpowiedzi. Zobaczysz to w rundzie 3.
I czwarta zasada, równie ważna: przy każdym złym przykładzie dopisz, co robić zamiast. Sam zakaz potrafi zadziałać odwrotnie, bo słowo „pasja” w prompcie to wciąż słowo „pasja” w głowie modelu. Dokumentacja Anthropic radzi wprost mówić, co model ma zrobić, a nie tylko czego ma unikać. W praktyce wygląda to tak:
ZŁY: „Kawa palona z pasją” → frazes.
ZAMIAST: konkretny fakt o paleniu, np. dzień palenia albo data na paczce.
Zły przykład stawia płot, a „zamiast” pokazuje furtkę. Razem działają lepiej niż każde osobno.
Symulacja na Claude Opus 5.5: trzy rundy
W tutorialu była branża kosmetyczna. Ja wziąłem sklep internetowy małej palarni kawy. Dlaczego? Bo to typowy mały sklep, w którym wszystko kręci się wokół konkretów: kiedy kawa była palona, skąd pochodzi, pod jaki ekspres jest mielona. Idealny poligon, żeby sprawdzić, czy model trzyma się faktów, czy je wymyśla. Marka jest wymyślona, nie podaję nazwy.
Runda 1: prompt bez przykładów
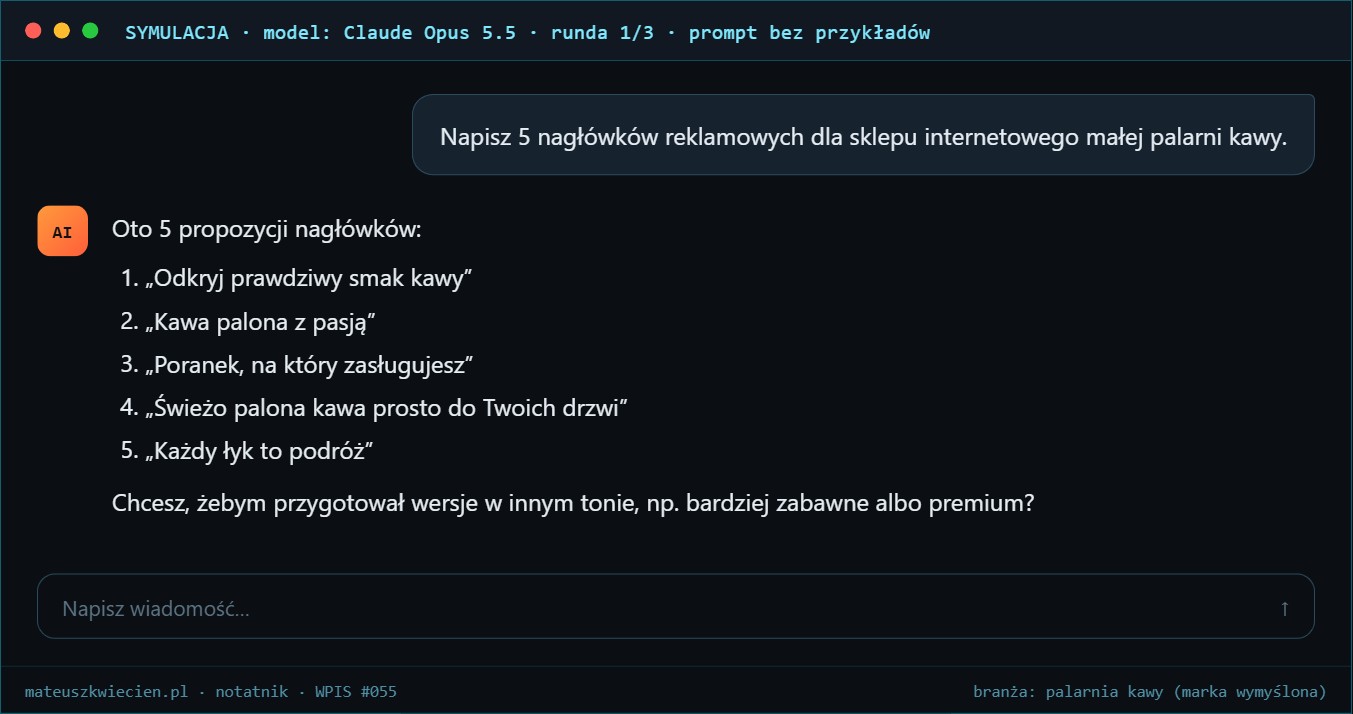
Klasyka. „Odkryj prawdziwy smak kawy”, „Każdy łyk to podróż”. Nic tu nie jest błędem, ale nic też nie sprzedaje. Model wybrał najbardziej prawdopodobne zdania o kawie, czyli przeciętne. To jest ta loteria z wpisu #054.
Runda 2: tylko dobre przykłady z komentarzem

Ogromny skok. Model połączył kropki: termin, świeżość, pochodzenie, obróbka. Nagłówek o Kolumbii Huila brzmi jak z dobrej palarni. Ale spójrz na czerwone fragmenty: „9 na 10 klientów”, „87% baristów”, „2x więcej aromatu”, „kawa sprzed 3 dni”. Nikt mu tych liczb nie dał. Zrozumiał, że lubię liczby, więc je dopisał.
Dokładnie to samo widać w tutorialu, z którego wziąłem metodę: ChatGPT wygenerował tam „92% kobiet potwierdziło…” i „85% klientek przyznało…”. W stylu idealne. W reklamie niebezpieczne, bo to wymyślony dowód społeczny. Wrócę do tego za chwilę.
Runda 3: dobre + złe przykłady + fakty
Trzy zmiany. Dodałem złe przykłady z komentarzem, w tym jeden wycięty prosto z błędu z rundy 2 („9 na 10 klientów” → wymyślona liczba). Dodałem listę faktów i zdanie „jedyne liczby, których wolno użyć”. I poprosiłem, żeby model najpierw spisał wytyczne, a przy każdym nagłówku podał, z którego faktu korzysta.


Tu widać, po co jest polecenie „przygotuj wytyczne dobrego i złego nagłówka”. Model musi najpierw na głos połączyć kropki, czyli zamienić moje komentarze w reguły. Dopiero potem pisze. Jeśli reguły są złe, widzę to od razu i poprawiam reguły, zamiast poprawiać pięć nagłówków po kolei.
I najlepsze zdanie z całej rozmowy, na samym końcu: „Jeśli chcesz nagłówek z liczbą klientów, podeślij dane — bez nich byłby zmyślony”. To nie jest grzeczność modelu. To efekt jednego złego przykładu z komentarzem.
Co zmieniła każda runda
| Runda 1 | Runda 2 | Runda 3 | |
|---|---|---|---|
| Co dałem | jedno zdanie | 3 dobre przykłady z komentarzem | 3 dobre + 3 złe z komentarzem + fakty + format |
| Styl | ogólny, frazesy | konkretny, trafiony | konkretny, trafiony |
| Liczby | brak | 4 zmyślone | tylko z listy faktów |
| Czy można puścić w reklamę | można, ale nic nie da | nie, bez sprawdzenia każdej liczby | tak, po zwykłej korekcie |
| Czego się uczę | bez przykładu = loteria | model łączy kropki, ale dopowiada | zły przykład stawia granicę |
Najważniejsza kropka: fakty zamiast zmyślonych liczb
Model zawsze uzupełni luki. Jak lubisz liczby, a liczb nie dasz, to je wymyśli. W poradnikach o promptowaniu nagłówki typu „92% klientek potwierdziło” wyglądają świetnie na zrzucie ekranu. W prawdziwej reklamie to problem: wymyślone badanie albo wymyślony odsetek zadowolonych klientek wprowadza w błąd, a wprowadzające w błąd informacje w reklamie mogą zostać uznane za nieuczciwą praktykę rynkową. Nie jestem prawnikiem, więc piszę ostrożnie, ale zasada jest prosta: liczba w reklamie musi mieć źródło w Twoich danych.
Dlatego w każdym prompcie z nagłówkami mam trzy rzeczy:
- listę faktów, z której model ma brać liczby,
- zdanie „jedyne liczby, których wolno użyć”,
- zły przykład ze zmyśloną liczbą i komentarzem „→ nie mamy takiego badania”.
Prośba „przy każdym nagłówku napisz, z którego faktu korzysta” to dodatkowy bezpiecznik. Jeśli model nie umie wskazać faktu, nagłówek leci do kosza.
Szablon prompta do skopiowania
Działa dla nagłówków reklam, tytułów wpisów, tematów maili i opisów produktów. Podmień nawiasy.
Napisz [5 nagłówków reklamowych] dla [sklep / produkt / branża].

Mam dla Ciebie przykłady, które mi się podobają, i takie, które mi się nie podobają, wraz z wyjaśnieniem dlaczego. Trzymaj się reguł, które wynikają z mojego omówienia. Nie wychodź poza nie.

DOBRE PRZYKŁADY:
1. „[przykład]” → [dlaczego jest dobry: liczba, termin, efekt, przyczyna, zwrot do odbiorcy…]
2. „[przykład]” → [dlaczego]
3. „[przykład]” → [dlaczego]

ZŁE PRZYKŁADY:
1. „[frazes]” → [dlaczego zły: ogólnik, nic nie mówi]
2. „[obietnica bez dowodu]” → [dlaczego zły: nie do sprawdzenia]
3. „[zmyślona liczba]” → [dlaczego zły: nie mamy takich danych]

FAKTY (jedyne liczby i twierdzenia, których wolno użyć):
- [fakt 1]
- [fakt 2]
- [fakt 3]

W ODPOWIEDZI:
- przygotuj wytyczne stylu dobrego i złego nagłówka zgodne z moimi sugestiami
- wygeneruj [5] przykładów
- przy każdym napisz, z którego faktu korzysta
- jeśli do dobrego nagłówka brakuje Ci danych, zapytaj zamiast zgadywać
Checklista
- Każdy przykład ma strzałkę „→ dlaczego”.
- Dobre i złe przykłady są wyraźnie podpisane i oddzielone.
- Złych przykładów jest nie więcej niż dobrych (to moja praktyka, nie twarda reguła).
- Przy każdym złym przykładzie jest „ZAMIAST: …”.
- Przynajmniej jeden zły przykład to błąd, który model zrobił wcześniej.
- Jest lista faktów i zdanie „jedyne liczby, których wolno użyć”.
- Model najpierw spisuje wytyczne, potem pisze.
- Przy każdym wyniku jest wskazany fakt. Bez faktu = do kosza.
Plan testu: jak to sprawdzić na prawdziwej reklamie
Tej techniki nie testowałem jeszcze na płatnej kampanii, więc zamiast wyników daję plan, który każdy może powtórzyć na swoim koncie.
- Dwa prompty: A — tylko dobre przykłady z komentarzem; B — dobre + złe przykłady z „ZAMIAST” + lista faktów.
- Z każdego weź 2 najlepsze teksty według siebie, nie według modelu.
- Puść je jako warianty w jednej kampanii (Meta Ads: ten sam zestaw reklam, ta sama grupa odbiorców, ten sam budżet).
- Mierz: CTR i koszt kliknięcia, a osobno: ile nagłówków z każdego promptu musiałeś odrzucić, bo zawierały zmyślone liczby.
- Czekaj minimum 7 dni albo do ok. 1000 wyświetleń na wariant, zanim cokolwiek wyłączysz.
- Ten drugi wskaźnik (odrzucone nagłówki) możesz zmierzyć od razu, bez wydawania złotówki.
Gdy ten test zrobię na sklepie, dopiszę wyniki tutaj z datą aktualizacji.
FAQ
Co to są anty-przykłady w prompcie?
To złe przykłady wklejone do prompta razem z komentarzem, dlaczego są złe. Pokazują modelowi AI granice: czego ma nie robić. Działają najlepiej, gdy są wyraźnie podpisane jako złe i oddzielone od dobrych.
Po co dopisywać komentarz do przykładu?
Bo sam przykład nie mówi, co w nim jest ważne. Komentarz w formie „→ dlaczego” pokazuje modelowi, jak połączyć kropki, czyli jaką regułę wyciągnąć z przykładu: liczbę, termin, efekt, przyczynę albo zwrot do odbiorcy.
Czy złe przykłady nie sprawią, że AI zacznie je kopiować?
Może się tak zdarzyć, jeśli nie są podpisane. Dlatego zawsze oznaczaj je jako ZŁE, dopisuj powód i dawaj ich nie więcej niż dobrych. Wtedy działają jak płot, a nie jak wzór.
Dlaczego AI wymyśla liczby w nagłówkach reklamowych?
Bo z przykładów wyczytało, że lubisz liczby, a nie dostało danych. Model uzupełnia luki. Rozwiązanie: lista faktów, zdanie „jedyne liczby, których wolno użyć” i zły przykład ze zmyśloną liczbą.
Czy AI potrzebuje feedbacku?
Tak. Model nie wie, co Ci się spodobało, dopóki mu nie powiesz. Najlepszy feedback mówi, co zrobił dobrze i co źle, a najlepiej zamienia się w bazę przykładów pozytywnych i negatywnych, którą wklejasz do kolejnych promptów.
Czy AI potrzebuje feedbacku?
Tak, potrzebuje. Model nie wie, co Ci się spodobało, dopóki mu tego nie powiesz. „Słabe, napisz jeszcze raz” to nie jest feedback, to kolejne losowanie. Dobry feedback ma dwie części:
- Co zrobił dobrze — żeby to powtórzył.
- Co zrobił źle — żeby to wyciął.
Tak wyglądałby mój feedback po rundzie 2 z symulacji:
DOBRZE:
- nr 4 „Kolumbia Huila…” → konkretne pochodzenie, efekt i przyczyna. Więcej takich.
- trzymasz krótką formę i zwrot do odbiorcy.

ŹLE:
- nr 1, 3, 5 → liczby, których nie mamy (9 na 10, 87%, 2x). Nigdy nie wymyślaj liczb.
- nr 2 → „sprzed 3 dni” to obietnica, której nie umiemy dotrzymać.

Popraw te 4 nagłówki, korzystając tylko z faktów, które zaraz wkleję.
Ale feedback w jednej rozmowie znika razem z tą rozmową. Nowy czat i model znowu zaczyna od zera. Część narzędzi ma już pamięć i projekty (Claude, ChatGPT), więc coś z Twoich uwag może przejść do kolejnych rozmów, ale nie wiesz dokładnie co i w jakiej formie. Dlatego i tak trzymaj własną bazę. Dlatego najlepiej zbudować bazę przykładów pozytywnych i negatywnych: jeden plik, do którego po każdej sesji dopisujesz to, co wyszło dobrze, i to, co wyszło źle, zawsze ze strzałką „→ dlaczego”. Taką bazę wklejasz na początek każdego prompta albo wgrywasz do projektu w Claude czy własnego GPT, żeby model miał ją pod ręką za każdym razem.
BAZA PRZYKŁADÓW — [sklep / kanał / format]
aktualizacja: [data]

✅ POZYTYWNE (tak piszemy)
- „[tekst]” → [dlaczego działa]
- „[tekst]” → [dlaczego działa]

❌ NEGATYWNE (tak nie piszemy)
- „[tekst]” → [dlaczego nie] · źródło: [model / konkurencja / my sami]
- „[tekst]” → [dlaczego nie]

📌 FAKTY (jedyne liczby, których wolno użyć)
- [fakt] · źródło: [skąd]
Każdy błąd modelu, który złapiesz, to darmowy anty-przykład do bazy. Po kilku tygodniach masz zestaw, którego nie da się kupić: Twój styl, Twoje granice i Twoje fakty w jednym pliku. I wtedy jedno zdanie prompta przestaje być loterią.
Źródła
- Anthropic, Use examples (multishot prompting) — dokumentacja o promptach z przykładami
- Anthropic, Prompt engineering overview — przegląd technik promptowania
- OpenAI, Prompt engineering — przewodnik po promptach
- Ustawa o przeciwdziałaniu nieuczciwym praktykom rynkowym — ISAP
- Symulacja rozmowy: Claude Opus 5.5, 8 października 2026, marka palarni wymyślona na potrzeby wpisu
Powiązane w notatniku: ciąg dalszy: łańcuch myśli i mapa decyzyjna (WPIS #056), przykłady w prompcie (WPIS #054), jak napisać prompt dla operatora czatu, jak testować prompt czatu.