// SPIS TREŚCI
Co to w ogóle jest Fish Audio
Link dostałem od żony na WhatsAppie o 20:14 z jednym zdaniem opisu: „TTS and voice cloning with unmatched emotion control”. Takie hasła zwykle odkładam na półkę „marketing producenta”. Tym razem wszedłem, bo od kilku tygodni robimy rolki reklamowe AI dla sklepu i głos jest w nich najsłabszym ogniwem — albo brzmi jak nawigacja w samochodzie, albo kosztuje tyle, co reszta produkcji razem.
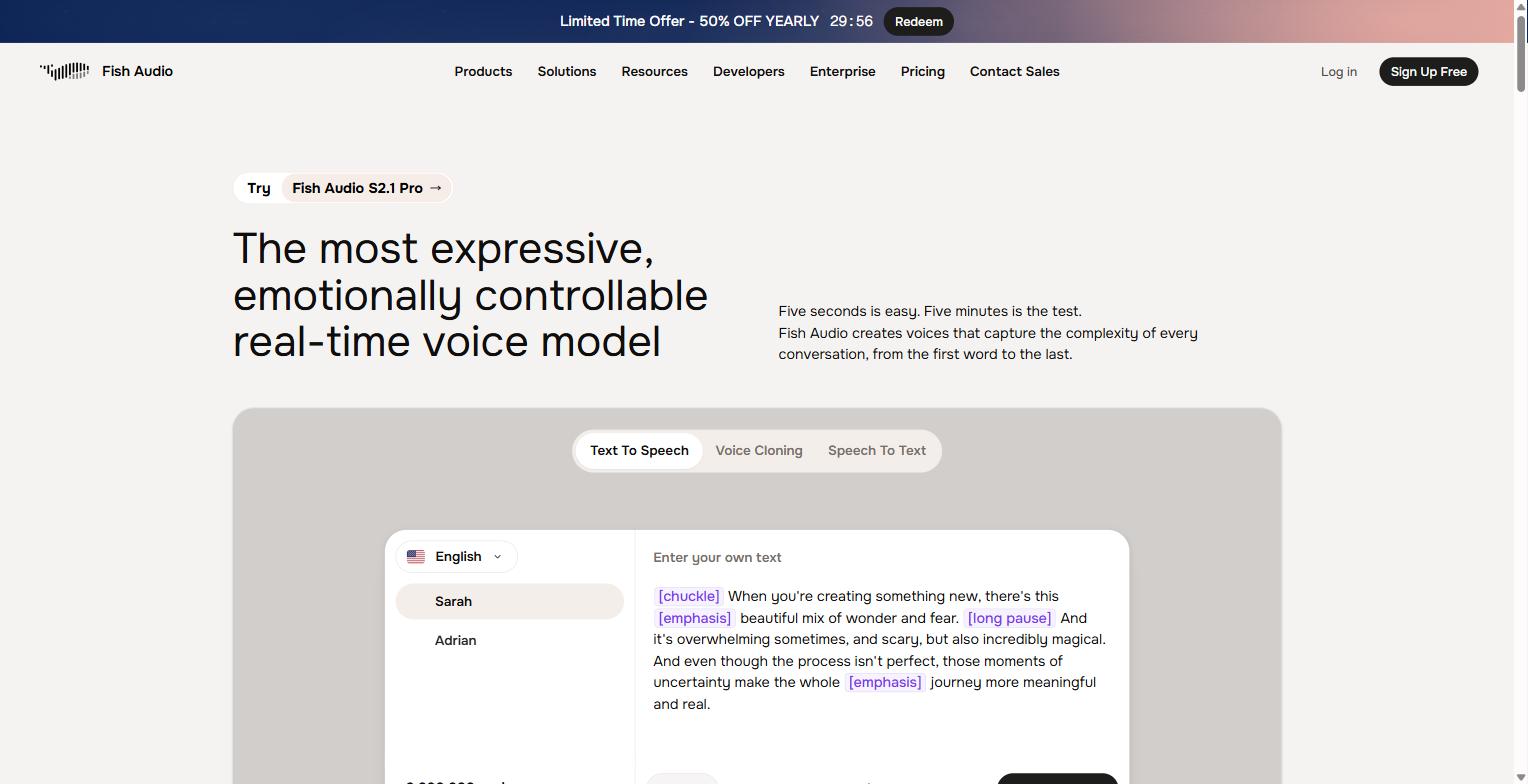
Fish Audio to platforma z trzema głównymi funkcjami: text-to-speech (aktualny model produkcyjny to S2.1 Pro), klonowanie głosu z krótkiej próbki oraz speech-to-text (modele transcribe-1 i transcribe-1-pro, ten drugi rozpoznaje wielu mówców i sygnały emocjonalne). Firma podkreśla korzenie open source — wcześniejsze projekty Fish Speech i Fish Diffusion są publicznie dostępne — i chwali się integracjami z platformami typu HeyGen czy Retell AI. Na stronie głównej deklaruje ponad 8 milionów użytkowników i „2 miliony+ głosów” w bibliotece.
Dla mnie ważniejsze niż liczby producenta jest to, jak zbudowany jest produkt: jest interfejs webowy dla nie-programisty (wklejasz tekst, wybierasz głos, pobierasz plik) i jest API z SDK dla kogoś, kto chce generować lektora automatycznie do setek wariantów reklam. Oba wejścia korzystają z tych samych modeli.
Kontrola emocji: znaczniki zamiast suwaków
To jest ta część, która mnie zatrzymała. W większości narzędzi TTS emocję ustawia się globalnie: „radosny”, „spokojny”, ewentualnie suwak tempa. W Fish Audio emocje i zachowania wpisuje się w tekst, w konkretnym miejscu, jako znacznik w nawiasie kwadratowym. W demie na stronie głównej widać to dosłownie:
[chuckle] When you’re creating something new, there’s this [emphasis] beautiful mix of wonder and fear. [long pause] And it’s overwhelming sometimes…
Dokumentacja wymienia dla S2.1 Pro „natural language control with bracket syntax” oraz obsługę wielu mówców w jednym tekście; starszy model S1 używał do tego samego nawiasów okrągłych. Lista przykładowych tagów na stronie: angry, sad, whispering, excited, laughing. Dla copywritera to zmiana sposobu pracy — scenariusz rolki pisze się razem z reżyserią głosu, w jednym pliku, i można go poprawiać jak tekst, a nie jak nagranie.
Klonowanie głosu w 15 sekund — i co z tego wynika prawnie
Producent deklaruje, że do stworzenia klonu wystarczy około 15 sekund nagrania. Zakładam, że jakość rośnie z długością i czystością próbki — to sprawdzę w teście. Ważniejsze jest jednak pytanie, czyj głos klonujesz. Moja zasada jest prosta i nie zamierzam od niej odchodzić:
- Klonuję wyłącznie własny głos albo głos osoby, która podpisała zgodę na piśmie z określonym zakresem użycia (reklama, kanał, okres).
- Nie klonuję głosów znanych osób, lektorów z YouTube ani „głosu podobnego do…”. To nie jest szara strefa, to jest wprost naruszenie dóbr osobistych — a w reklamie dodatkowo ryzyko wprowadzenia w błąd.
- W materiałach reklamowych z syntetycznym głosem dopisuję informację, że lektor jest wygenerowany. Nie dlatego, że ktoś mnie zmusza, tylko dlatego, że buduję markę na mówieniu prawdy — także o narzędziach.
Warto pamiętać, że regulacje dotyczące oznaczania treści generowanych przez AI (w Unii — AI Act) wchodzą etapami; jeśli robisz reklamy na rynek unijny, oznaczanie syntetycznych treści to kierunek, w którym i tak trzeba iść.
Gdzie syntetyczny głos ma sens w reklamie
| Zastosowanie | Sens | Dlaczego |
|---|---|---|
| Rolki produktowe 9:16 (Meta, TikTok, YT Shorts) | duży | Krótki tekst, dużo wariantów, szybka iteracja — tu koszt nagrania z lektorem zabija testy A/B. |
| Warianty językowe tej samej reklamy | duży | Jeden scenariusz, jeden głos, kilkadziesiąt języków w API — testowanie rynków bez castingu. |
| Explainery i tutoriale do produktów cyfrowych | średni | Głos ma być czytelny, nie charyzmatyczny. Ryzyko: monotonia przy długich tekstach. |
| Reklama radiowa / spot z emocją jako nośnikiem | mały | Tu wciąż wygrywa człowiek. Dobry lektor „gra” tekst, model go czyta — nawet z tagami. |
| Czatboty głosowe i obsługa klienta | średni | Niska latencja (producent obiecuje ok. 100 ms do pierwszego dźwięku w S2 Pro) — ale to inna dyscyplina niż reklama. |
Moja ocena z pozycji małego sklepu, który robi kreacje sam. W agencji z budżetem na castingi rachunek wyglądałby inaczej.
Haczyki: licencja, polski, latencja
Licencja komercyjna
Plan darmowy ma miesięczny limit generacji i — to najważniejsze zdanie na stronie cennika — użytek komercyjny wymaga płatnego planu. Reklama sklepu to użytek komercyjny. Nie ma tu miejsca na kombinowanie: jeśli lektor z Fish Audio ma trafić do kampanii, płacisz. Konkretnych stawek celowo nie przepisuję, bo zmieniają się częściej niż ten wpis; sprawdź cennik w dniu zakupu.
Język polski
Na stronie głównej wymienionych jest osiem języków głównych (angielski, japoński, koreański, chiński, francuski, niemiecki, arabski, hiszpański) — polskiego wśród nich nie ma. Dokumentacja modelu S2.1 Pro mówi o 83 językach w API. To znaczy tyle: polski prawdopodobnie „jest”, ale jakość dla języka poza pierwszą ósemką trzeba sprawdzić uchem, na własnych tekstach, z własnymi nazwami produktów. Dopóki tego nie zrobię, nie napiszę, że „działa po polsku”.
Latencja i stabilność
Dla reklamy latencja nie ma znaczenia — generujesz plik raz. Ma znaczenie stabilność brzmienia między generacjami: jeśli ten sam głos brzmi inaczej we wtorku i w czwartek, seria rolek przestaje być serią. To też punkt do testu.
Mój roboczy workflow: tekst → głos → rolka
- Scenariusz w trzech wariantach (hook, korzyść, CTA), każdy do 25 sekund czytania. Piszę od razu ze znacznikami emocji — inne przy hooku, inne przy CTA.
- Jeden głos na markę. Albo klon własny, albo jeden głos z biblioteki zapisany jako „głos sklepu”. Zmiana głosu między rolkami to zmiana marki.
- Generacja i odsłuch na telefonie, nie na monitorach. Rolki oglądają ludzie w autobusie.
- Montaż z klatkami, które robimy w narzędziach do wideo AI (o tym w wpisie #045 o previzie).
- Oznaczenie „głos wygenerowany” w opisie i, jeśli format pozwala, w kadrze.
Plan testu w tym notatniku
Tego narzędzia jeszcze nie testowałem na kampanii. Zamiast zmyślać, spisuję plan i wrócę z wynikiem.
- Sklonować własny głos z 15 s i z 2 min nagrania. Wygenerować ten sam tekst po polsku w obu klonach i w dwóch głosach z biblioteki. Odsłuch ślepy: żona i dwie osoby spoza firmy wskazują, który brzmi „jak człowiek”.
- Zrobić trzy rolki z identycznym obrazem i różnym lektorem: człowiek (ja, nagrany telefonem), Fish Audio z tagami emocji, Fish Audio bez tagów.
- Puścić je w jednej kampanii Meta z równym budżetem na zestaw. Mierzyć: zatrzymanie po 3 s (hook rate), obejrzenia do końca, CTR do sklepu. Bez zmian w kreacjach w trakcie.
- Opisać wynik z liczbami — także wtedy, gdy człowiek wygra o dwie długości. To będzie równie dobry wpis.
FAQ
Czy Fish Audio jest darmowe?
Jest plan startowy bez opłat z miesięcznym limitem generacji, ale użycie komercyjne — a reklama nim jest — wymaga płatnego planu. Aktualne stawki są na stronie cennika.
Czy mogę sklonować głos znanego lektora albo celebryty?
Nie. Głos jest dobrem osobistym; klonowanie bez zgody to naruszenie prawa i — w reklamie — dodatkowo wprowadzanie w błąd. Klonuj własny głos albo głos osoby z pisemną zgodą.
Czy Fish Audio mówi po polsku?
Dokumentacja modelu S2.1 Pro wymienia 83 języki w API, ale polskiego nie ma wśród ośmiu języków eksponowanych na stronie głównej. Jakość dla polskiego trzeba sprawdzić samodzielnie na własnych tekstach — ja zrobię to w teście opisanym wyżej.
Jak działa kontrola emocji?
Znaczniki typu [chuckle], [emphasis], [long pause] wpisuje się bezpośrednio w tekst, w miejscu, gdzie mają zadziałać. Emocję ustawia się więc lokalnie, na poziomie frazy, a nie globalnie dla całego nagrania.
Czy syntetyczny lektor jest lepszy od człowieka w reklamie?
Nie wiem — i nikt, kto tego nie zmierzył na własnej kampanii, też nie wie. Dlatego w notatniku jest plan testu, a nie werdykt.
Źródła
- fish.audio — strona główna (odczyt 25.09.2026)
- Fish Audio Docs — Models Overview (S2.1 Pro, S2 Pro, S1, transcribe-1)
- Fish Audio — Text to Speech API
Powiązane w notatniku: previz Blender → Seedance: reklama wideo AI, GPT-6 Astra vs Claude Fable 5.1, newsjacking.
— MK · wróć do notatnika